Um consumidor Kafka que acompanha o pico
Um serviço consome um tópico Kafka e alimenta o Elasticsearch. No pico, o lag só subia.
- no consumo e na chegada dos dados à busca, com o mesmo HPA pela CPU
- 4,5 a 5×
O problema
Lotes de até 2.000, tratados 100 mensagens de cada vez, cada uma com a sua consulta e o seu envio. Duas chamadas por mensagem prendiam a CPU com pouca vazão: o HPA subia instâncias, só uma por partição consumia, e o lag seguia subindo.
O que eu mudei
Uma consulta com as chaves do lote inteiro e a saída em pedaços de 500. As chamadas passaram a ser por lote, não por mensagem, e cada instância ganhou folga com a mesma CPU: as que o HPA sobe esvaziam a fila.
Como funciona
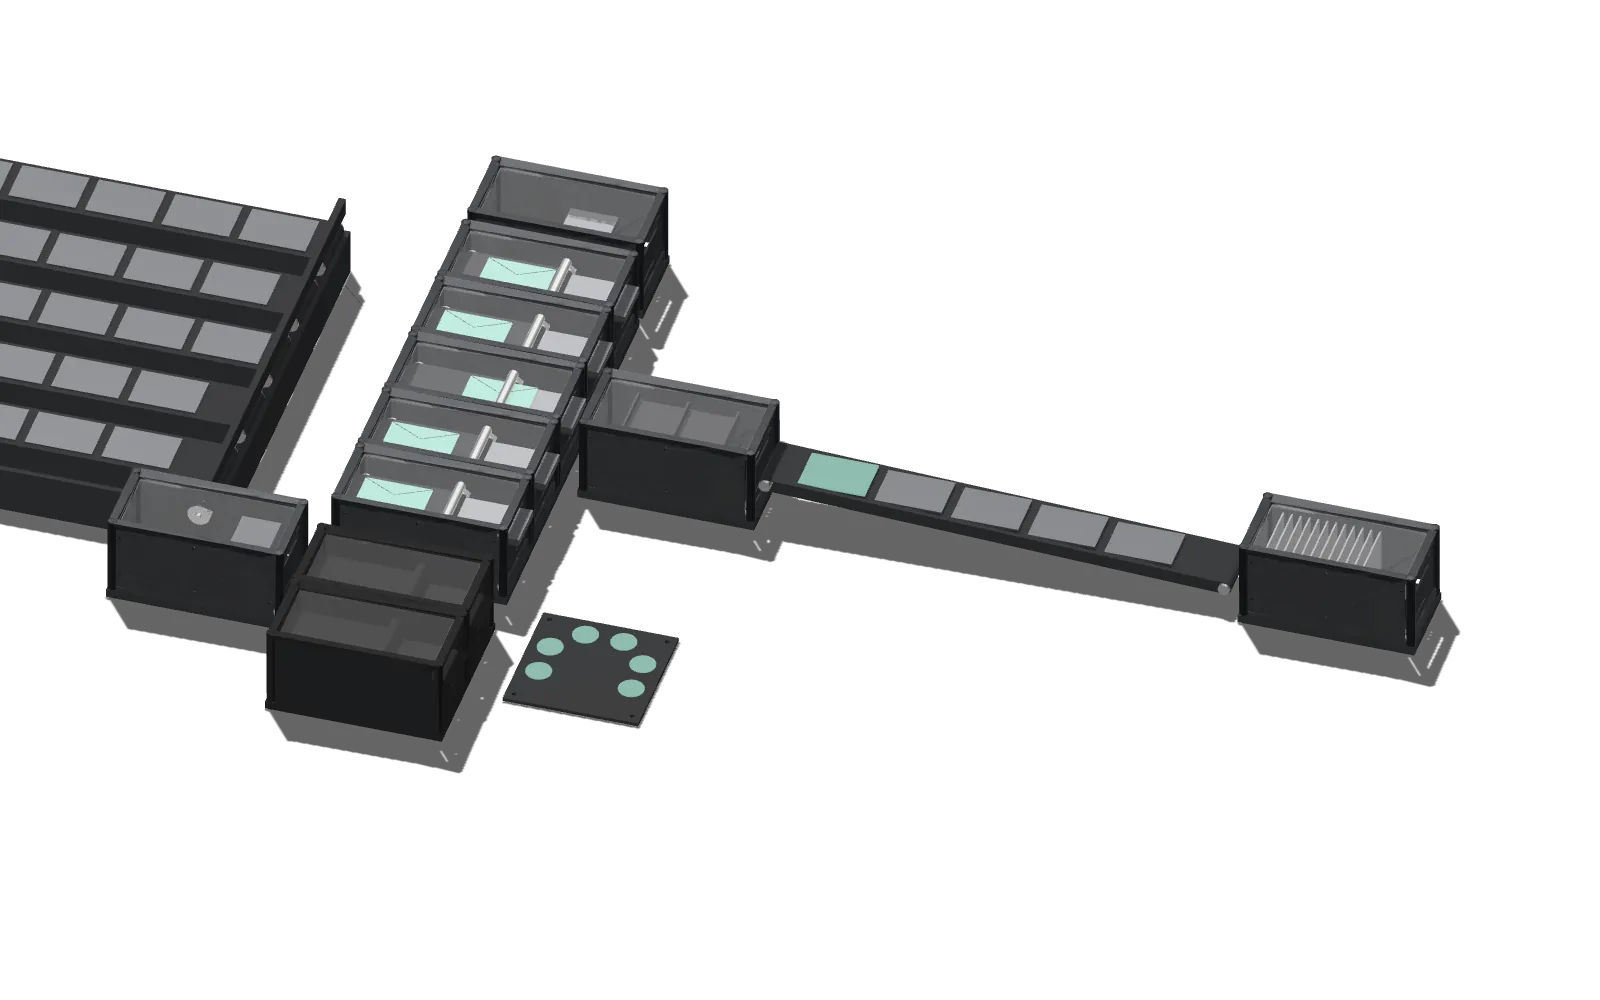
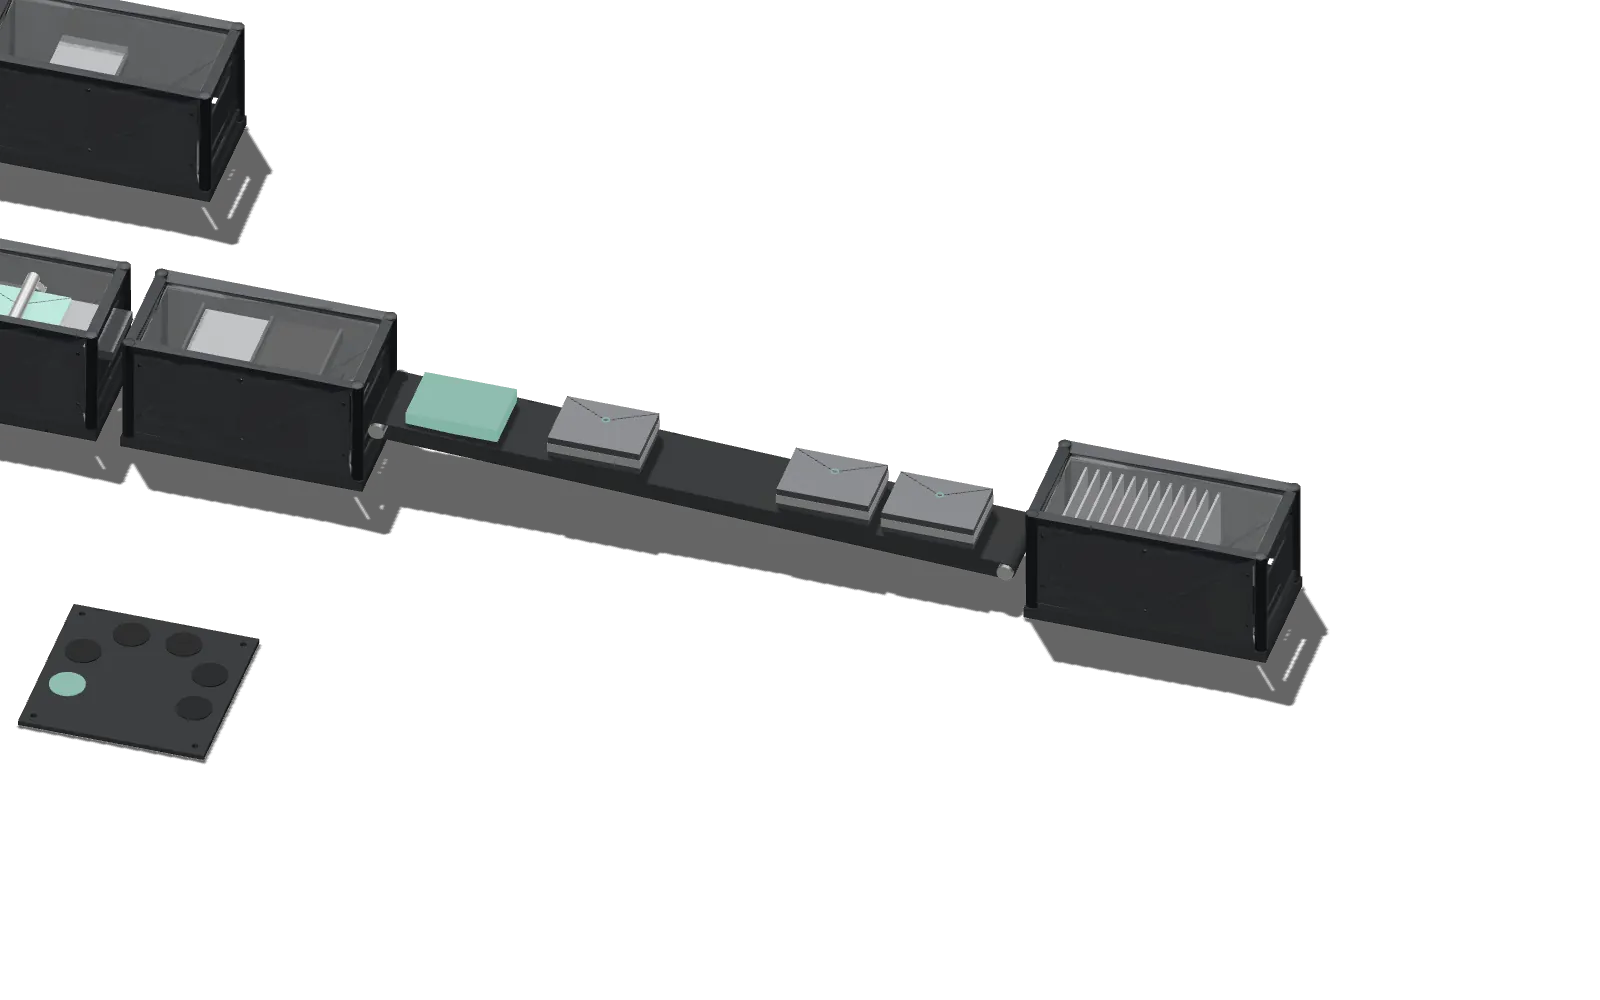
Os parâmetros
- Lote máximo (B)
- 2.000 msg
- Concorrência, antes (C)
- 100 msg
- Pedaço, depois (S)
- 500 msg
- Chaves distintas (N)
- 5.000 chaves
- Consulta, custo fixo (q₀)
- 2 ms
- Consulta, por chave (q_k)
- 0,05 ms
- Processamento (m)
- 0,4 ms
- Envio (c)
- 3 ms
- Commit (k_c)
- 2 ms
- CPU por chamada (κ)
- 0,85 ms
- Núcleos (n)
- 1 núcleo
- Partições (P)
- 5 partições
- Alvo de CPU do HPA (u*)
- 70 %
- Vazão por instância a plena carga, antes e depois
- 476 → 2.176 msg/s
O tempo de um lote de b mensagens
lote    b = min(fetch, B)
antes   ℓ = q₀ + q_k + m + c
        τ(b) = max(⌈b/C⌉·ℓ, b·(m + 2κ)/n) + k_c
depois  K(b) = N·(1 − (1 − 1/N)^b)
        τ(b) = q₀ + q_k·K(b) + m·b + ⌈b/S⌉·c + k_c
Tem um consumidor que não acompanha o pico? Vamos conversar sobre ele.