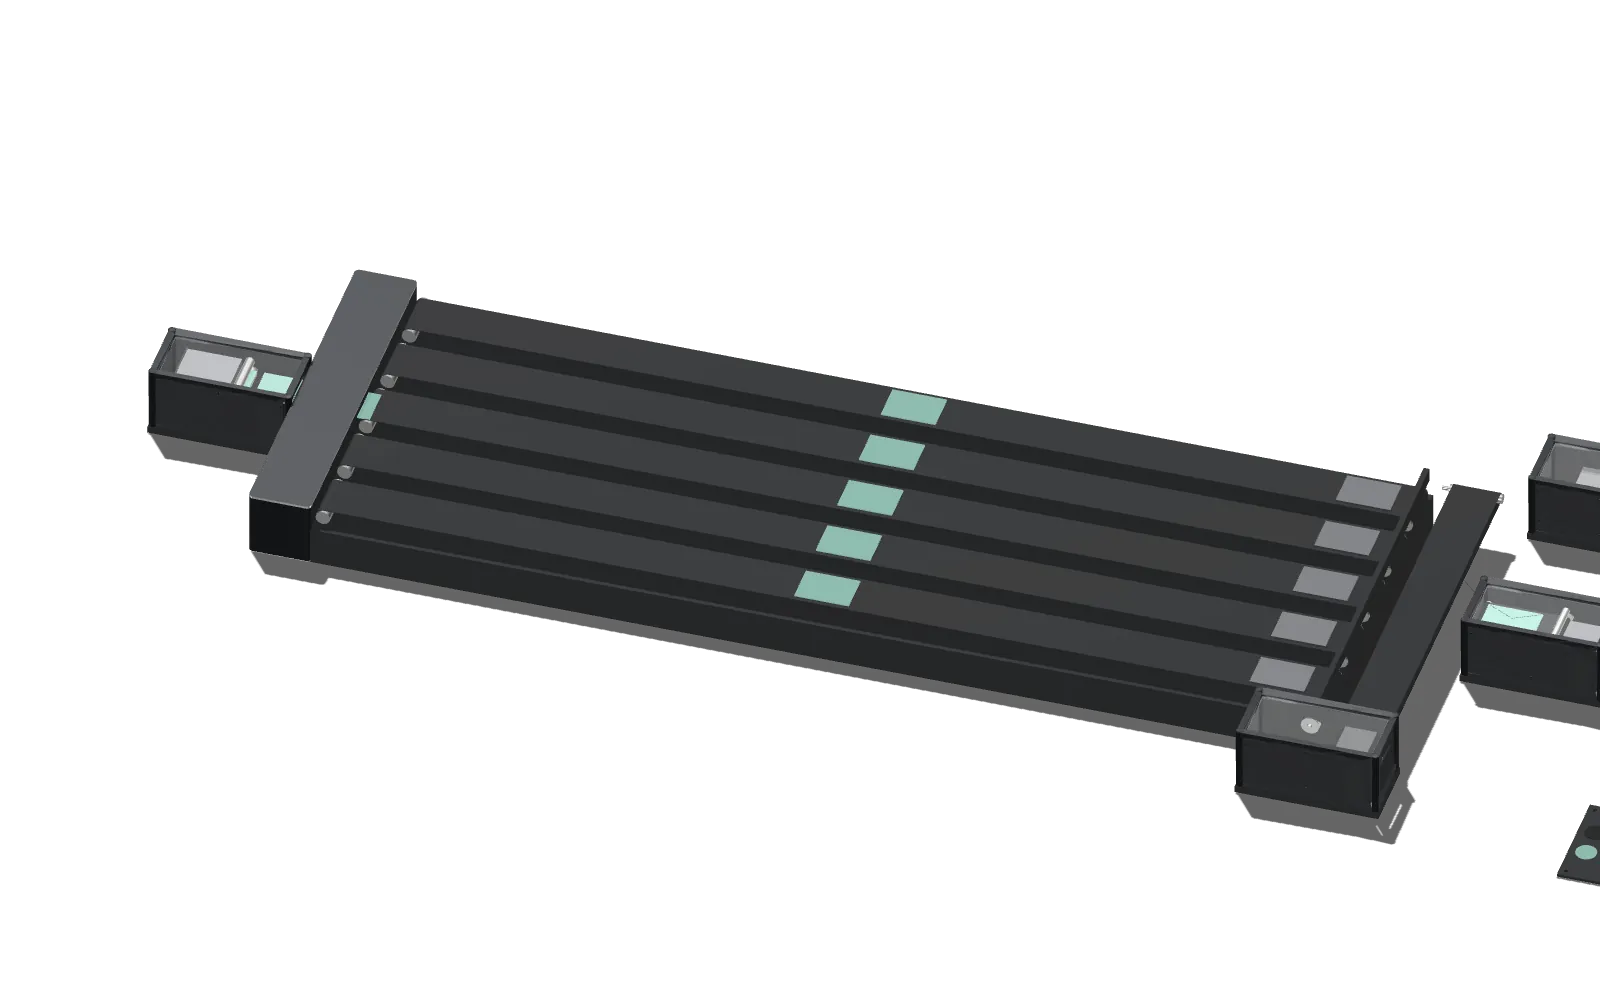
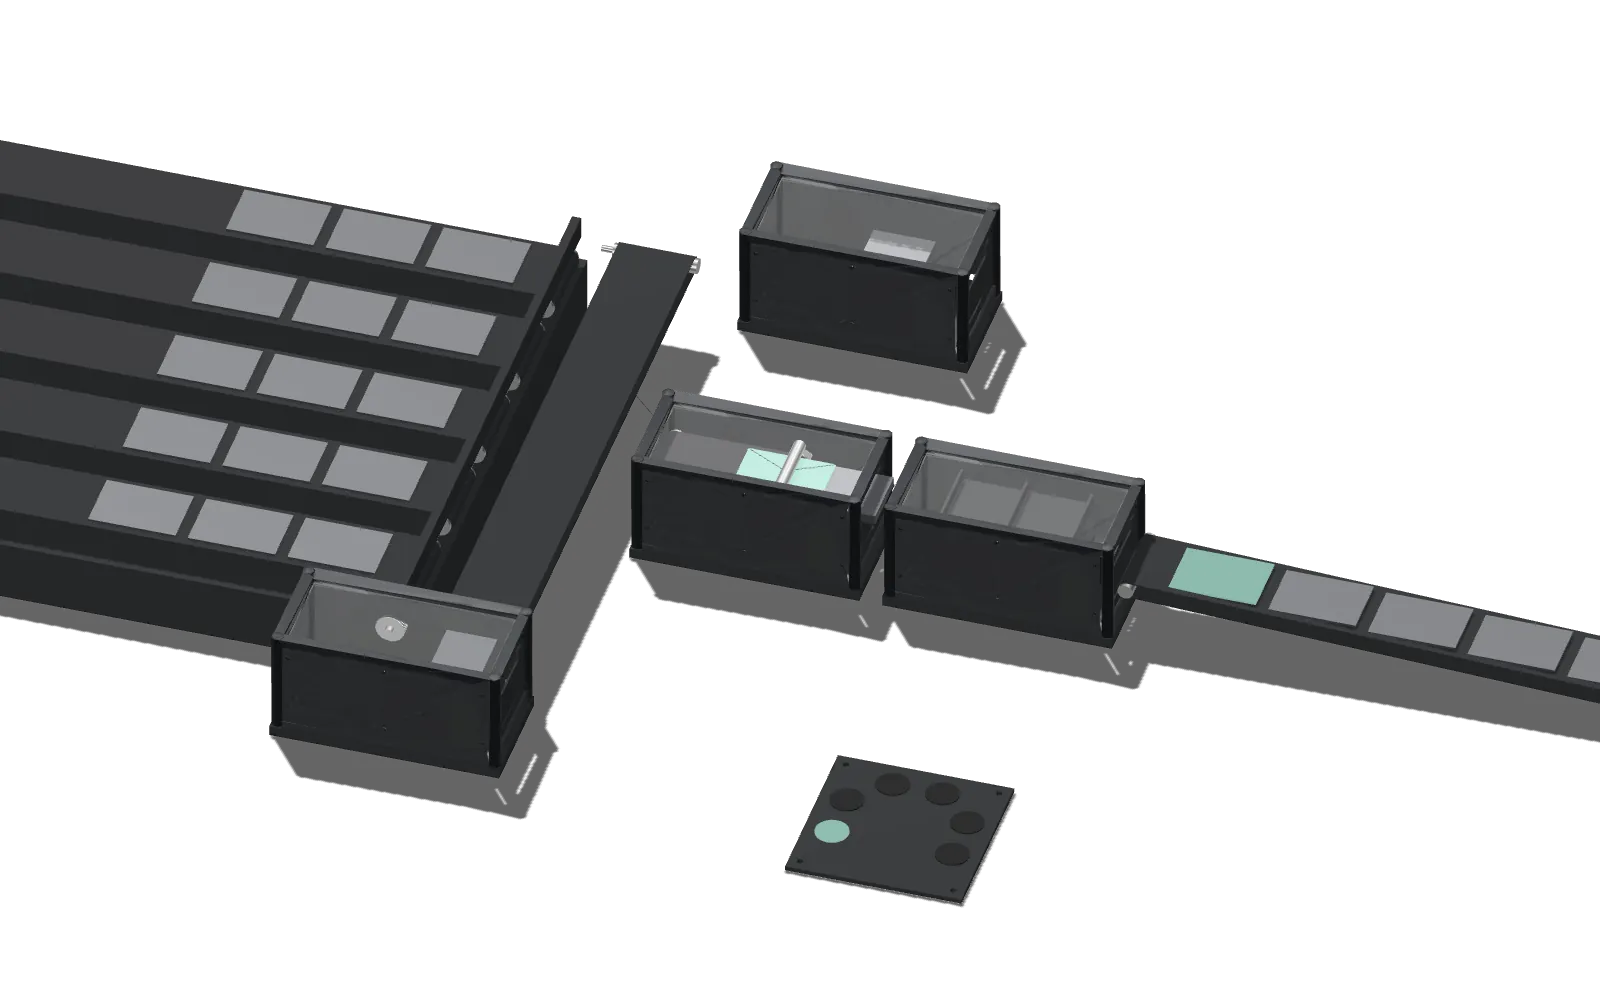
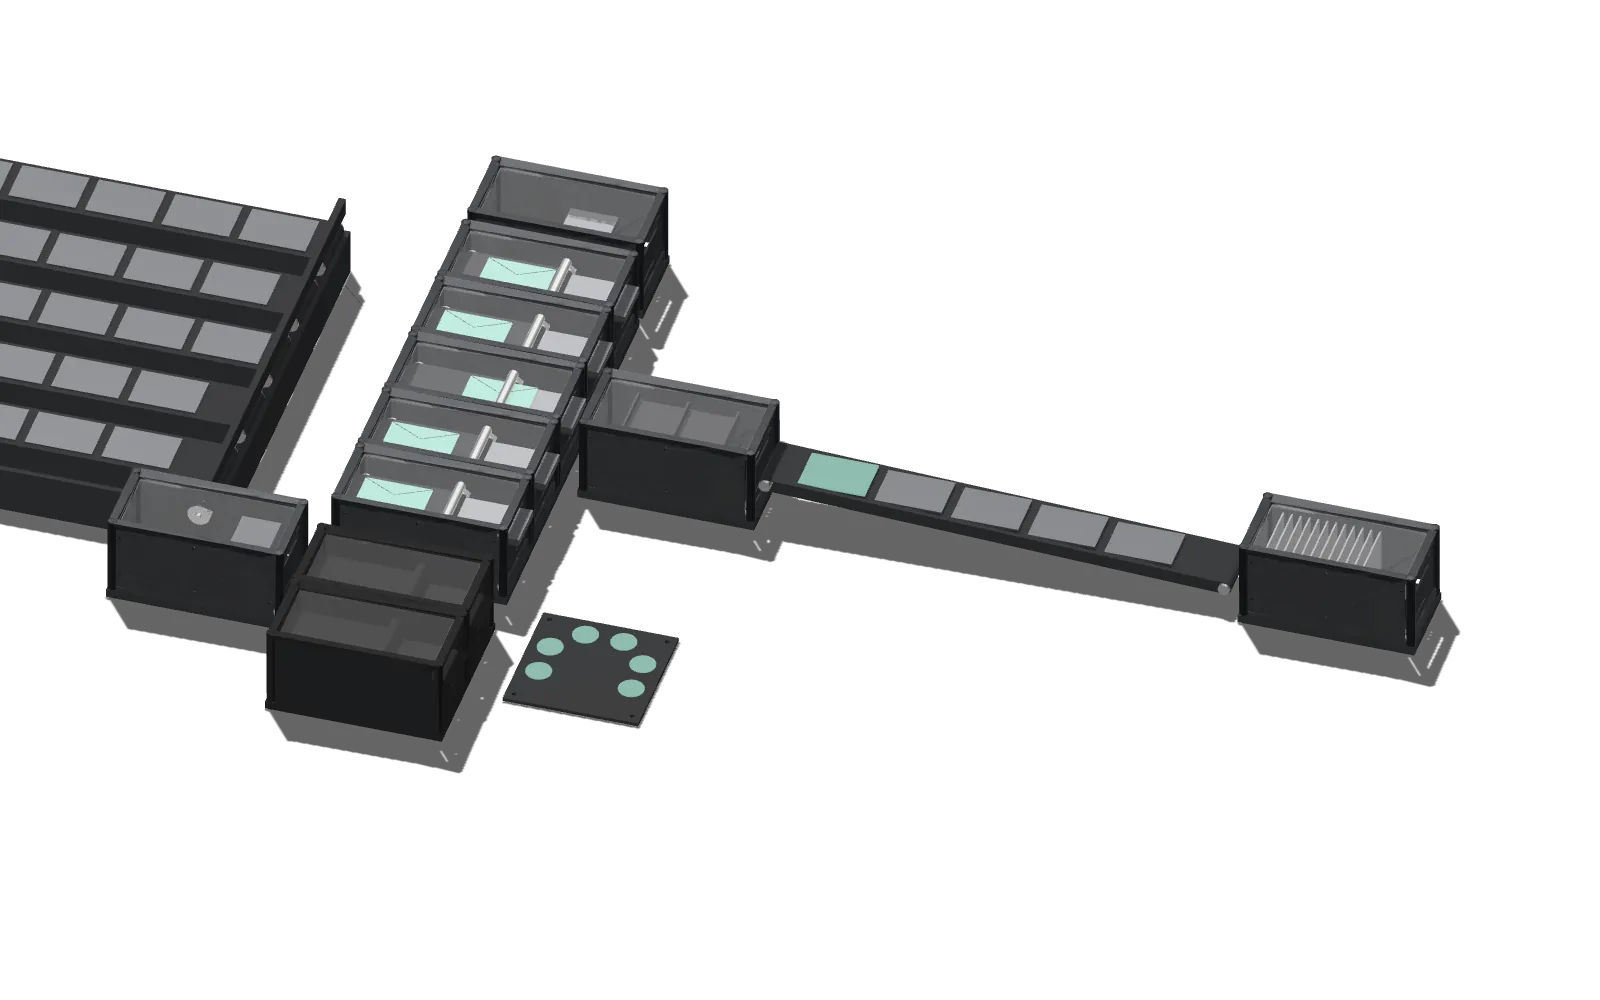
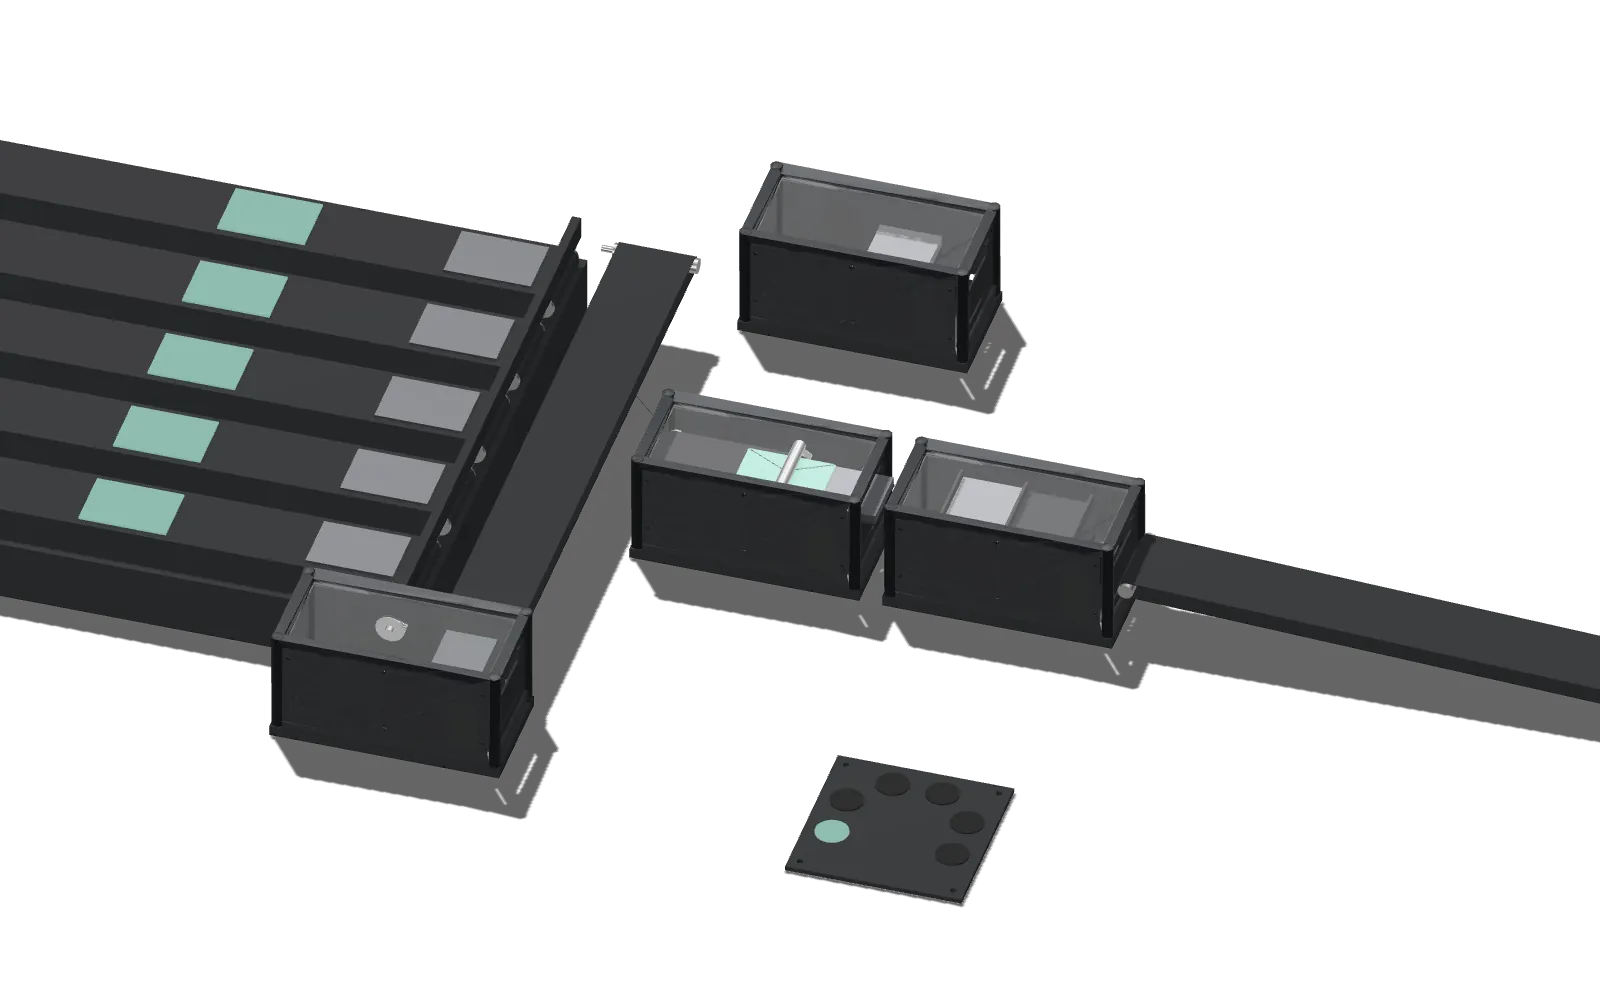
Um consumidor Kafka que acompanha o pico
Um serviço consome um tópico Kafka e alimenta o Elasticsearch. No pico, o lag só subia.
Claudio Mascaro
EnglishAs mensagens chegam ao tópico mais rápido do que o serviço consome.
A diferença é o lag.
Antes, lotes de até 2.000.
Mas cada mensagem com a sua própria consulta, 100 de cada vez.
O lag sobe, e o dado chega atrasado à busca.
Cada mensagem vira um sendMessage sozinho no tópico de saída.
Com um commit por lote.
O HPA sobe instâncias, uma por partição, e o lag segue subindo.
Depois, troquei as consultas por uma só para o lote inteiro.
Os mesmos lotes de até 2.000.
A saída vai em pedaços de 500, um de cada vez.
Cada um espera a confirmação do broker, e o tópico do Logstash recebe em cadência, sem rajada.
Com o mesmo HPA pela CPU, o lag sobe mais devagar.
No pico, cada instância tem folga.
E as que o HPA sobe esvaziam a fila.
O consumo e a chegada dos dados à busca subiram de 4,5× a 5×.
Tem um consumidor que não acompanha o pico?
Uma cadeia de suprimento de software.
Times em npm, Go, PyPI, Maven e NuGet, cada um buscando de uma fonte própria.
Sai o aviso de uma versão vulnerável no npm.
Bloqueá-la é passar fonte por fonte, enquanto os builds puxam pelas que seguem abertas.
Eu pus um hub na frente dos registros: o Nexus.
Um bloqueio nele cobre quem migrou, e as fontes antigas ainda levam a versão a quem ficou.
Depois, as fontes antigas são desativadas.
Sobra um lugar para bloquear, e um bloqueio no hub cobre todos os times.
O hub vira um serviço de uma plataforma interna de desenvolvimento (IDP).
Só o pipeline publica: build atestado e assinado, scan no OWASP Dependency-Track.
Quem consome confere a assinatura e o atestado.
Chega uma cópia adulterada do pacote interno.
O digest não bate com o atestado, e o hub a retém.
Se passasse, a admissão a recusaria.
Quer um lugar só para bloquear o que não deve entrar?
Uma cadeia de suprimento de software com um lugar só para bloquear →
Eu construo sistemas distribuídos, AI Native ou não.E recupero os que estão lentos, caros ou falhando, por diagnóstico e cirurgia.Tudo sai com a Esteira de Confiabilidade: uma pessoa aprova, a máquina publica.
Engenheiro de software e SRE, com ampla experiência em infraestruturas de pagamento. Aplico os fundamentos de engenharia de IA nas duas escalas: em empresa grande, onde recurso não é o gargalo, e nos meus produtos, onde é.
Senior SRE hoje, aberto a oportunidades de Staff SRE. Trajetória
Dois problemas que eu resolvi, e dois sistemas meus.
Um serviço consome um tópico Kafka e alimenta o Elasticsearch. No pico, o lag só subia.
Times em npm, Go, PyPI, Maven e NuGet, cada um buscando pacotes de uma fonte própria.
Atendimento por IA numa operação de homecare, sobre um CRM próprio: inbox, takeover e liberação humana. A palavra final é de uma pessoa, num lugar feito para isso.
A mesma plataforma, em marca branca, para operações de saúde. O desenho aceita uma segunda marca sem virar um segundo sistema: a esteira é a mesma, o dono muda. É onde o modo por projeto com manutenção já roda.